Představte si lék, který škodí mužům i ženám. Přesto vám celková statistika tvrdí, že pacienta zachrání. Vítá vás Simpsonův paradox, jeden z nejzákeřnějších jevů moderní statistiky. Ve druhém dílu seriálu o kauzální inferenci se podíváme na to, proč nám ani ta nejčistší čísla neřeknou pravdu, pokud k nim neznáme ten správný příběh.
Na základě ohlasů na předchozí polemiku o kauzálním salátu a přístupu Richarda McElreatha přichází čas na pokračování. Tentokrát se vydáme po stopách izraelsko-amerického počítačového vědce Judea Pearla a jeho zásadní knihy The Book of Why. Celý tento text vychází primárně z kapitoly číslo 6 (Paradoxes galore) zmíněné knihy.
Příspěvek jsem se snažil koncipovat ve filmovém duchu Star Wars: každý díl je pochopitelný samostatně. Stejně jako diváci tehdy nepotřebovali k pochopení Darth Vadera znát jeho původ, nepotřebujete ani vy k pochopení Simpsonova paradoxu mít dopředu nastudovaný předchozí „kauzální salát“. Když si ale přečtete oba díly, získáte mnohem hlubší vhled a celý problém vám do sebe zapadne v daleko širších souvislostech.
A pro pořádek: slavný Simpsonův paradox nemá s Homerem Simpsonem na úvodním obrázku nic společného. Není to pouhá kuriozita ze statistické učebnice. Je to průhledové okno do samotné podstaty kauzálního myšlení.
Případ doktora, který nevěřil vlastním datům
Dejme tomu, že jste lékař. Čtete právě publikovanou studii o novém léku D na prevenci infarktu. Studie byla observační, takže pacienti si sami zvolili, zda lék užijí. Tabulka výsledků vypadá takto:
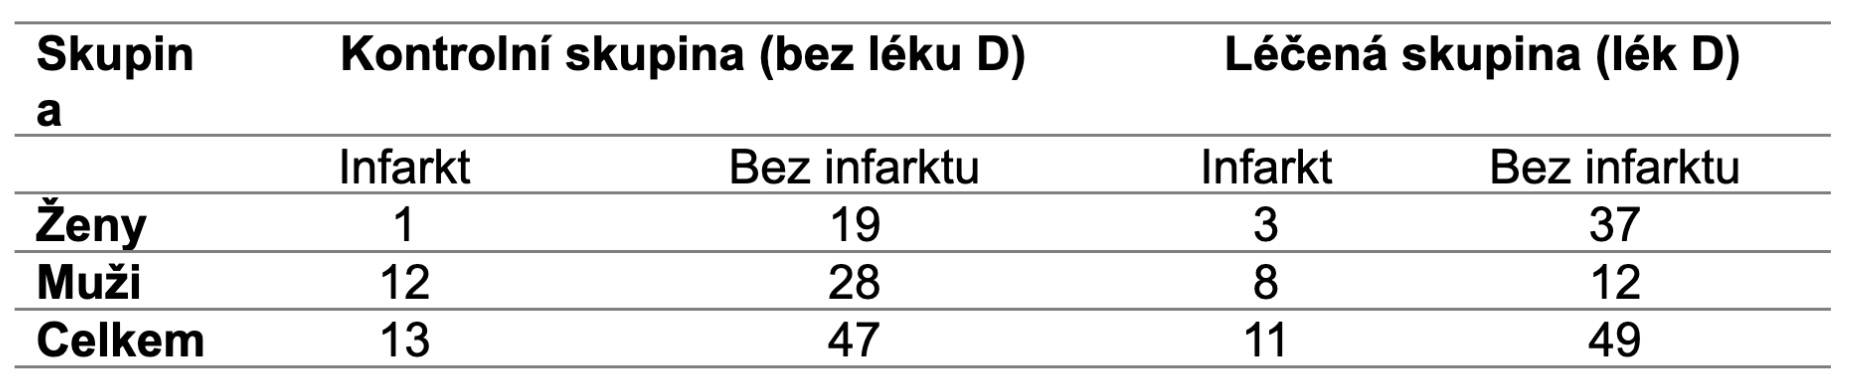
Podíváte se na celkový součet: bez léku dostalo infarkt 13 z 60 pacientů (21,7 %), s lékem jen 11 z 60 (18,3 %). Zdá se to jasné: lék funguje, pacienti by ho měli dostat. Zavřete studii, napíšete doporučení.
A pak si z jakéhosi nutkání tabulku prohlédnete podrobněji. A najednou se vám zatočí hlava. U žen bez léku dostala infarkt 1 z 20, tedy 5 %. U žen s lékem 3 ze 40, tedy 7,5 %. Lék u žen škodí. U mužů bez léku dostalo infarkt 12 ze 40, tedy 30 %. U mužů s lékem 8 z 20, tedy 40 %. Lék u mužů škodí. V obou podskupinách, u žen i u mužů lék zvyšuje riziko infarktu. A přesto celkově vychází jako prospěšný.
Situaci výstižně shrnul statistik Melvin Novick již v roce 1983: logickým závěrem by bylo lék nepodávat mužům, nepodávat ženám, ale podávat ho lidem, jejichž pohlaví neznáme. To je samozřejmě zcela absurdní. Jedno ze tří tvrzení musí být nutně špatně. Ale které? A proč?
Toto je Simpsonův paradox. Trend patrný v každé podskupině se při sloučení dat obrátí. Výsledek, který vidíte v celkovém součtu, je pravý opak toho, co říkají rozčleněná data. Tento jev bývá někdy doplněn zkratkou BBG (bad-bad-good), špatný pro ženy, špatný pro muže, dobrý pro lidi.
Jak je to možné? Odpověď leží v jediném slově: váhy. Pohlaví zde hraje roli tzv. konfounderu, tedy proměnné, která ovlivňuje zároveň dvě věci. Zaprvé, kdo lék bere: ženy si lék zvolily výrazně častěji (40 z 60) než muži (20 z 60). Zadruhé, výchozí riziko infarktu: muži mají přirozeně šestinásobně vyšší riziko než ženy (30 % vs. 5 % v kontrolní skupině). Léčená skupina proto vypadá celkově lépe — ne proto, že lék pomáhá, ale proto, že ji tvoří převážně ženy s přirozeně nízkým rizikem. A to je přesně ten moment, kdy statistika bez kauzálního myšlení selhává.
Simpsonovo obrácení v baseballových statistikách
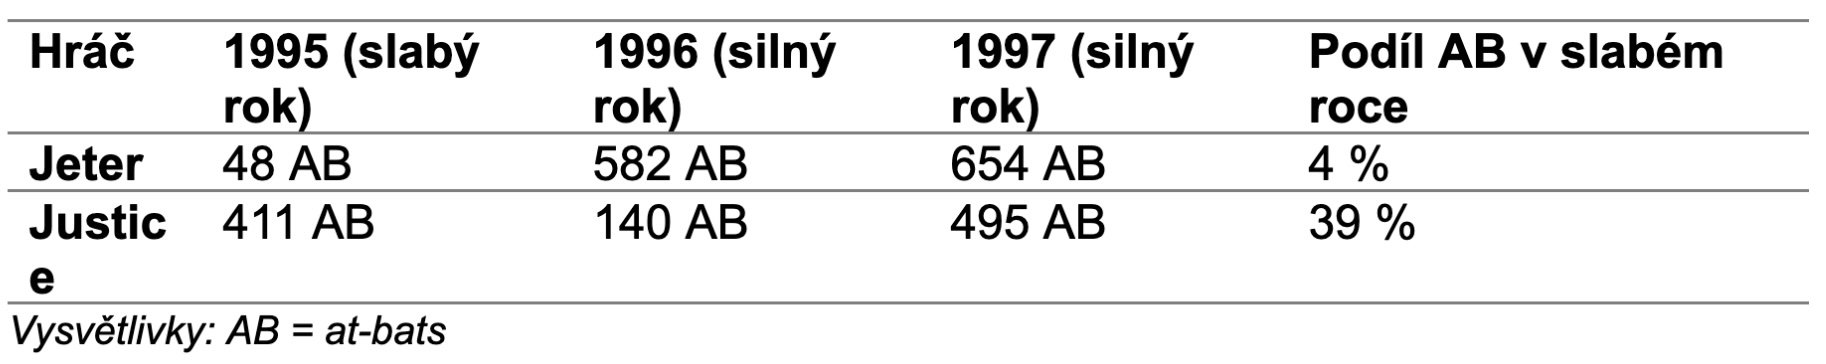
Než přejdeme k realizaci Pearlova názorného vysvětlení, ilustrujme tento paradox na příkladu přímo ze sportovních ročenek (viz tabulka 2). Podívejme se na reálná data ze zámořské baseballové MLB z let 1995–1997. Sledujeme pálkařský průměr (batting average) dvou legend: Dereka Jetera a Davida Justiceho. Pálkařský průměr se počítá jednoduše: je to počet úspěšných zásahů (hitů) dělený počtem všech příležitostí na pálce (at-bats). Čím je vyšší, tím je hráč lepší.
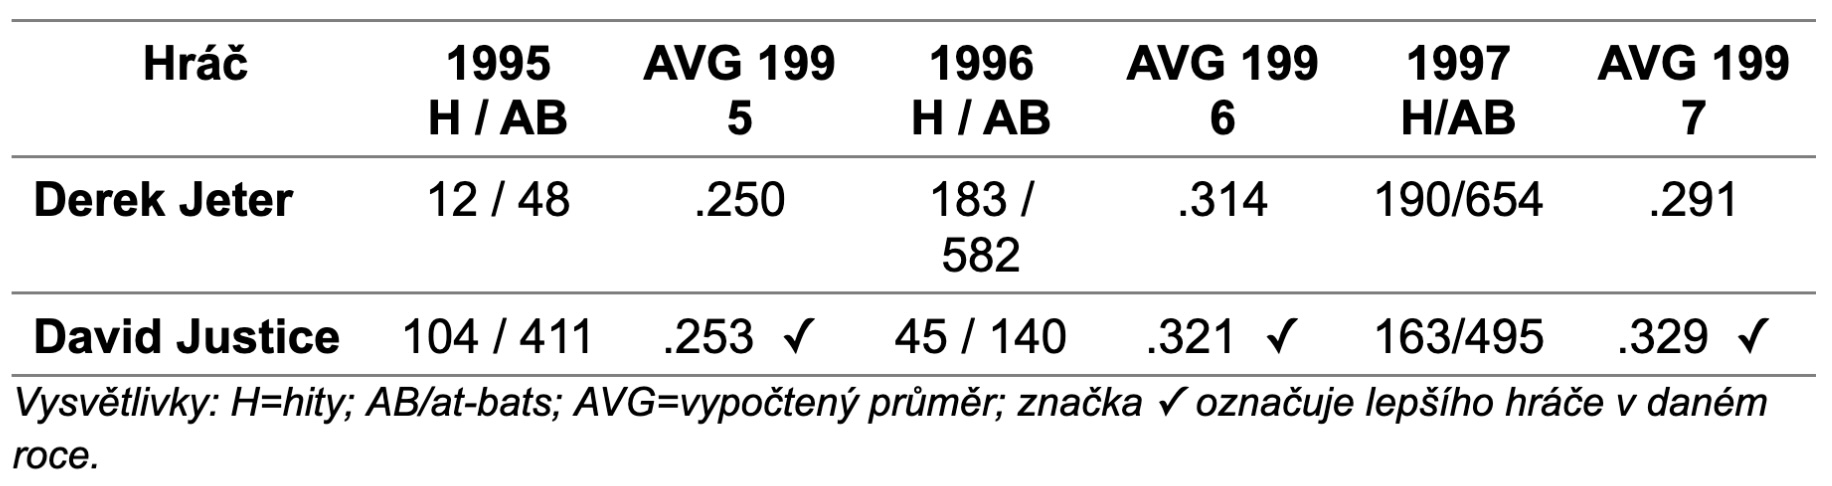
Justice byl lepší v každém sledovaném roce lepší. A přesto, když se podíváme na celkový součet za tři sezóny, Jeter vede průměrem .300 versus .298. Justice byl v každém roce lepší, ale celkově prohrál. Toto je Simpsonovo obrácení (Simpson’s reversal) v čisté podobě a s reálnými daty (viz tabulka 3).
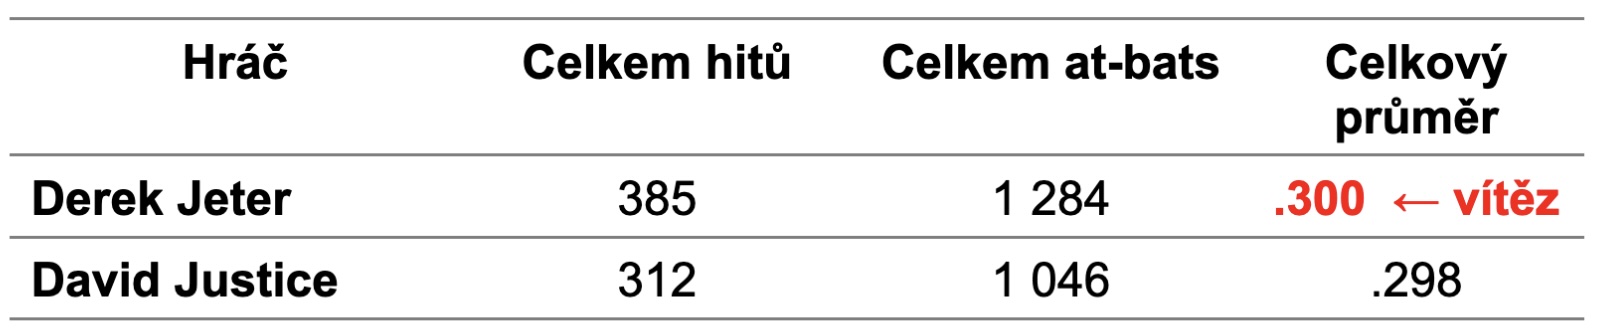
Intuitivně bychom čekali, že pokud je A lepší než B v každé kategorii (každý rok), musí být A lepší i celkově. Ale to platí pouze tehdy, pokud mají obě kategorie stejnou váhu, tedy stejný počet příležitostí. Důvod? V roce 1995 byl Jeter dvacetiletý nováček a dostal jen 48 příležitostí na pálce (kde se mu nedařilo). Justice byl v plném nasazení a odehrál 411 pokusů. Naopak v roce 1996 se Justice zranil a odehrál jen 140 pokusů, zatímco Jeter exceloval. Souhrnný průměr je totiž vážený průměr – a váhy (počet pokusů) se v čase dramaticky měnily (viz tabulka 4).
Jak Pearl Simpsonův paradox řeší: konfounder, nebo mediátor?
Pearl zdůrazňuje, že Simpsonův paradox sám o sobě není statistickým omylem. Je to symptom – signál, který nám říká, že v datech existuje skrytá proměnná, jejíž ignorování vede k překvapivým (a potenciálně nebezpečným) závěrům. A klíčová otázka zní: Co s tou skrytou proměnnou máme dělat?
Pearl rozlišuje dva zásadně odlišné případy, které data sama od sebe nedokáží rozlišit. Záleží na tom, zda je třetí proměnná konfounder (matoucí proměnná, která ovlivňuje zároveň příčinu i výsledek), nebo mediátor (zprostředkovatel efektu, který leží na kauzální cestě mezi příčinou a výsledkem).
Táž čísla, jiný kauzální graf, jiný závěr
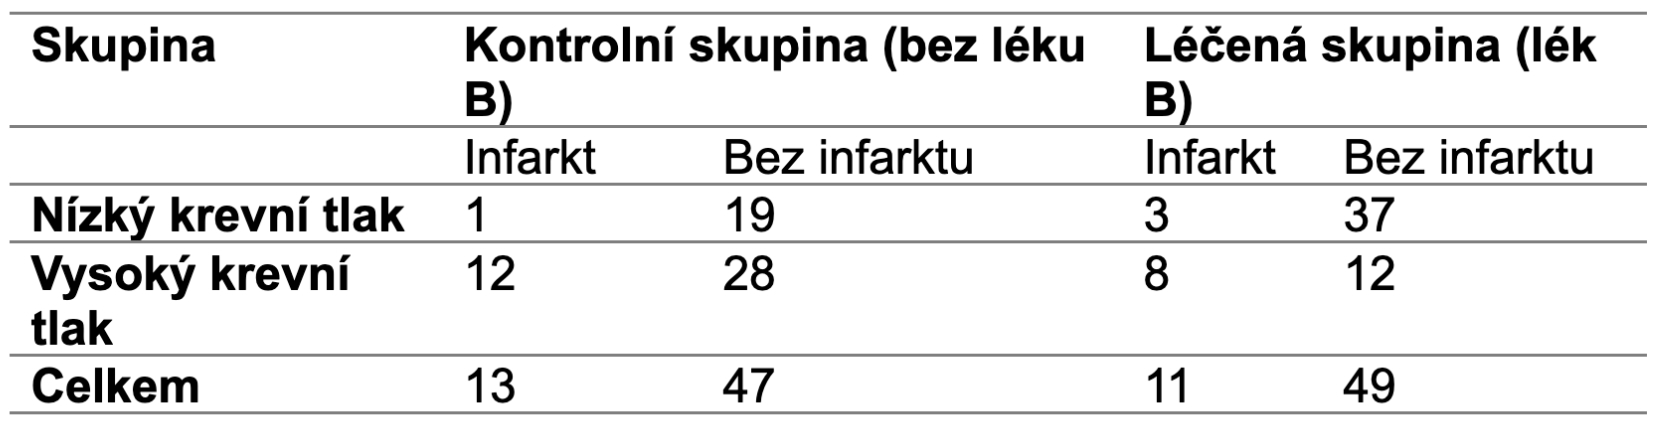
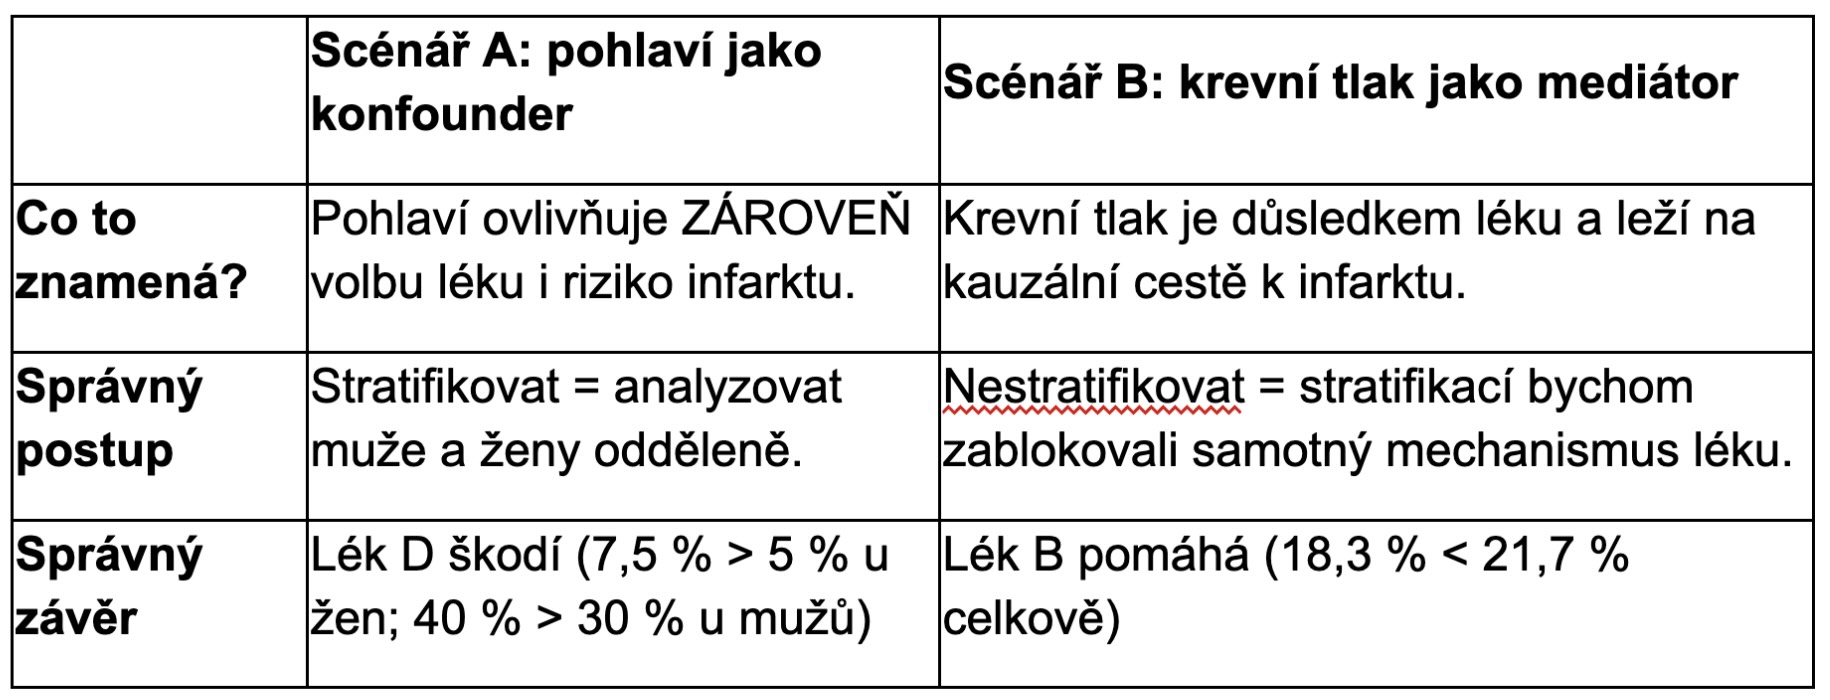
Jdeme zpět k datům z tabulky 1 a zkusíme si vysvětlit, jak tento paradox řeší Pearl. Čísla v tabulce 5 zůstanou naprosto stejná jako v tabulce 1, ale s odlišným kontextem. Změní se pouze příběh o tom, jak data vznikla, tedy kauzální model. A výsledek bude opačný.
Scénář A: Pohlaví jako konfounder – stratifikuj
 Ve studii léku D si pacienti sami zvolili, zda lék vezmou. Ženy měly výraznou tendenci lék brát (40 z 60 žen, tedy 67 %), muži naopak nikoliv (jen 20 z 60, tedy 33 %). Zároveň muži přirozeně čelí šestinásobně vyššímu riziku infarktu než ženy, 30 % oproti 5 % v kontrolní skupině.
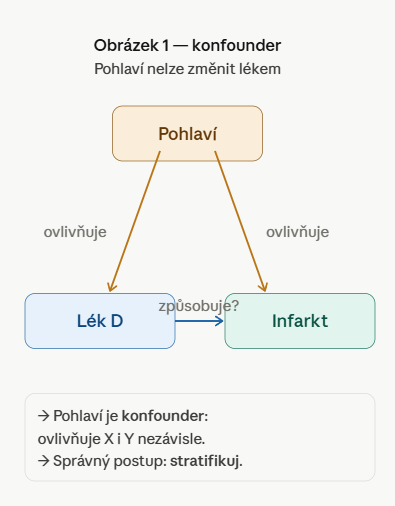
Pohlaví tedy ovlivňuje zároveň dvě věci: kdo lék bude brát a jaké má výchozí riziko. To je přesná definice konfounderu. Kauzální diagram (obrázek 1) to vyjadřuje jednoduše. Pohlaví stojí v horním vrcholu trojúhelníku a šipky vedou dolů jak k léku, tak k infarktu. Jde o tzv. backdoor cestu.
Správný postup je stratifikovat, tedy analyzovat muže a ženy odděleně a výsledky vážit přirozeným rozložením pohlaví v populaci (50/50). Výsledek je jednoznačný: riziko infarktu bez léku je 17,5 % (průměr 5 % a 30 %), s lékem 23,75 % (průměr 7,5 % a 40 %). Lék D je škodlivý. Pearl to stručně shrnuje: lék D není BBG (bad for women, bad for men, but good for people). Je BBB = bad for women, bad for men, and bad for people.
Scénář B: Krevní tlak jako mediátor – nestratifikuj
Pearl nyní předkládá druhý příběh se zcela identickými čísly. Tentokrát jde o lék B, o němž víme, že snižuje krevní tlak. Právě přes tento mechanismus má snižovat riziko infarktu. Výzkumníci proto po léčbě změřili krevní tlak pacientů a zaznamenali, zda dostali infarkt. Tabulka 5 vypadá identicky jako tabulka 1, nízký krevní tlak odpovídá řádku žen, vysoký krevní tlak řádku mužů, čísla jsou stejná.
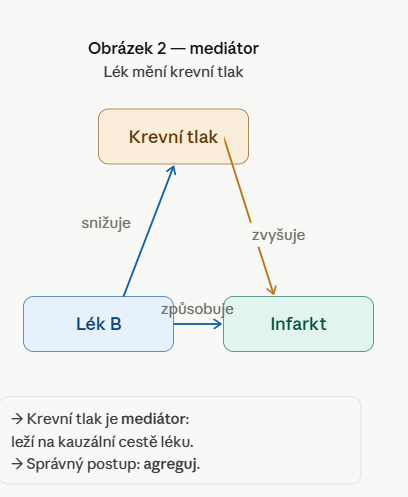 Klíčový rozdíl je v kauzálním diagramu (obrázek 2). Krevní tlak tentokrát nestojí v horním vrcholu trojúhelníku jako nezávislý konfounder. Stojí na cestě mezi lékem a infarktem jako mediátor. Lék B snížil krevní tlak u dvakrát více pacientů než v kontrolní skupině (40 z 60 oproti 20 z 60). Přesně to má dělat lék proti infarktu, přesouvá lidi z vysokorizikové skupiny do nízkorizikové.
Kdybychom v tomto scénáři stratifikovali podle krevního tlaku, zablokovali bychom hlavní mechanismus, jímž lék působí. Srovnávali bychom lék a kontrolu až po zohlednění změny, která je sama důsledkem léčby. Bylo by to jako hodnotit účinek léku proti bolesti, ale výsledek porovnávat jen u lidí, jimž bolest neustoupila. Tedy přesně těch, u nichž lék nezabral. V tomto případě jsou správná agregovaná data: lék B pomáhá.
Klíčová pointa tedy je, že data sama o sobě nemohou říct, který scénář platí. Na tuto otázku nedokáže odpovědět žádný statistický test, žádná p-hodnota, žádný koeficient. Záleží výhradně na procesu, který data vygeneroval, na kauzálním modelu. Právě proto Pearl považuje tento příběh za důležitou demonstraci celé knihy: stejná čísla, opačný závěr. A správnou odpověď najdete jedině tehdy, když se přestanete dívat do tabulky a začnete přemýšlet o světě (viz tabulka 6).
Grafické znázornění Simpsonova paradoxu
Jeden moudrý matematik mi řekl: pokud to jde, snaž se data vždy graficky znázornit. Pokud jste tedy dočetli až sem a máte stále pocit, že nechápete, jak může účinek existovat a zároveň neexistovat, tak následující grafy a vysvětlující text by vám mohly pomoci.
Pearl v této pasáži přechází od binárních dat (lék ano/ne, infarkt ano/ne) ke spojitým proměnným a ukazuje, že k tomuto paradoxu dochází i zde. V tomto případě je možná ještě přesvědčivější, protože ho lze doslova vidět.
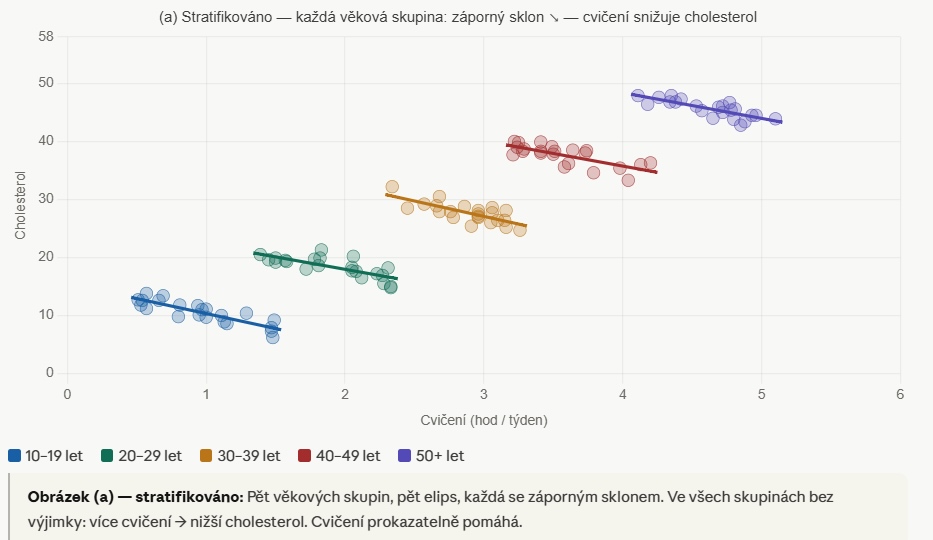
V ilustrativním příkladu sleduje objem týdenního cvičení (osa X) a hladinu cholesterolu (osa Y) v různých věkových skupinách. Ve stratifikovaném pohledu (viz obrázek 3a) tvoří každá věková skupina samostatnou elipsu se záporným sklonem: čím více lidé cvičí, tím nižší mají cholesterol. Cvičení tedy prokazatelně pomáhá.
Jakmile ale věkové skupiny sloučíme do jedné velké „elipsy” (obrázek 3b), sklon se obrátí a je kladný. Náhle se zdá, že čím více lidé cvičí, tím vyšší mají cholesterol. Cvičení tak zdánlivě škodí.
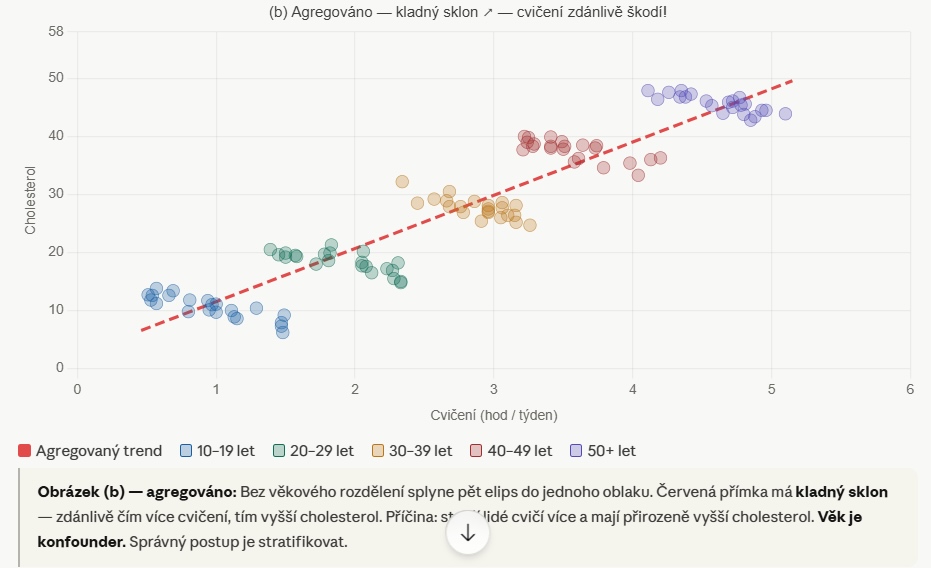
Příčina je stejná jako v předcházejících případech: konfounder (matoucí proměnná), v tomto případě věk. Starší lidé přirozeně cvičí více, ale zároveň mají přirozeně vyšší cholesterol, a to bez ohledu na cvičení. Věk tedy ovlivňuje obě proměnné nezávisle na sobě a při celkové agregaci dat tento efekt převáží nad skutečným přínosem cvičení.
Pearl pak uzavírá, že se musíme vždy podívat na příběh, který se skrývá za daty. Protože věk ovlivňuje míru cvičení (nikoli naopak) a zároveň působí na cholesterol, je věk konfounder. Správným postupem je v tomto případě stratifikace. Závěr ze stratifikovaných dat je pak správný: cvičení cholesterol snižuje.
Kde vzniká riziko
Přirozeně vzniká otázka: je Simpsonův paradox vzácná kuriozita, nebo reálné riziko?
Odpověď je nepříjemná: je to reálné riziko, a to zejména tam, kde jsou observační data normou, tedy v naprosté většině výzkumů v behaviorálních, sociálních a biomedicínských vědách.
Simpsonův paradox v plné síle (tedy skutečné obrácení trendu) je jedna věc. Ale analogický problém nastává i tehdy, kdy k obrácení nedojde, ale výsledky jsou přesto systematicky zkreslené kvůli nerovnoměrnému zastoupení skupin. A s tím se ve výzkumu můžeme setkávat často. Podmínky pro jeho vznik, jako různě velké skupiny, skrytá matoucí proměnná, observační design, jsou v naprosté většině výzkumů, které čteme a publikujeme, splněny.
Pearl nám říká: problém není v datech. Data jsou přesná. Problém je v absenci příběhu a kauzálního modelu, který by nám řekl, jak data interpretovat. Táž tabulka čísel může vést ke dvěma přesně opačným závěrům, a oba mohou být statisticky správné. Rozhoduje kauzální struktura světa, který za daty stojí.
Jak píše Nate Silver ve své knize Signál a šum: „Čísla sama o sobě mluvit nedokážou. My mluvíme za ně. My jim dáváme význam.“
Poděkování: Děkuji Claudovi a Geminimu za jejich trpělivost a kapacitu při iteracích, za věcné připomínky a za to, že si po zakoupení placených verzí nikdy nestěžovali.
Autor: Ladislav Baloun & AI (Claude & Gemini)
Zdroje: The book of why: The new science of cause and effect – Pearl, J., & Mackenzie, D., Signál a šum: Mnoho předpovědí selže. Některé ne. – Silver, N.
Příspěvky z rubriky Názory nijak nevyjadřují názory a postoje redakce.
- Autor článku: ne
- Zdroj: VědaVýzkum.cz