


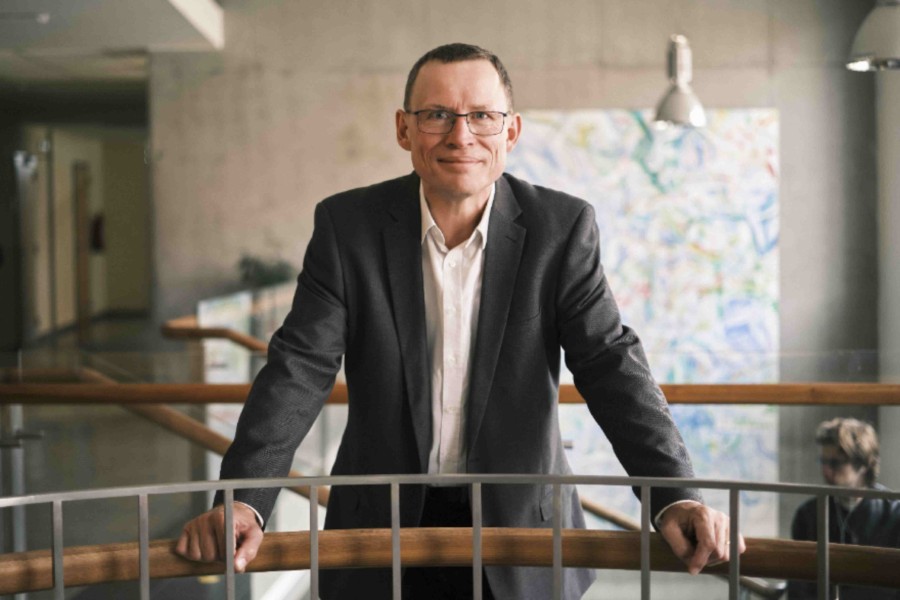
Rozpoznávání řeči se od ručního přepisování posunulo k AI modelům, které dnes umí detekovat i lidský stres. S technologií ale rostou rizika. „Zlým hochům bychom systémy nikdy nedodali,“ říká Jan Černocký, počítačový vědec, přední český odborník na zpracování řeči a laureát ceny Česká hlava. V rozhovoru popisuje složitý boj proti deepfakům, budoucnost umělé inteligence nebo využití technologie v národní bezpečnosti.
Naši konverzaci nahráváme. Pokud bychom záznam podrobili práci systémů analýzy řeči, co všechno o nás dokáží zjistit?
Rozhodně přepis – ten vám dnes udělá jakýkoliv rozpoznávač od Googlu, českých firem i mnoha dalších. Pokud byste měl předem připravenou či zaregistrovanou moji nahrávku, dokázaly by zjistit i to, zda jsem Jan Černocký, tedy verifikaci řečníka. Dnes už by zvládly provést i identifikaci deepfaku – tedy zda jsem to opravdu já, nebo jestli se za mě vydává nějaký syntetizátor či voice converter. To je nicméně ambice, kterou za pár let asi budeme muset vzdát.
A pak by vám systém poskytl základní statistiky: jak dlouho mluvím, jak si skáčeme do řeči nebo kolik toho namluvím já a kolik vy. Možná by zjistil i některé základní údaje o stresu, únavě a podobně. V tomto oboru také působíme, ale myslím si, že k absolutním výsledkům se tam nikdy nedobereme – maximálně půjde detekovat, že člověk je na začátku hovoru v klidu a pak ho vystresujete a naopak, víc vám ale neřekne. V neposlední řadě by systém také dokázal rozpoznat, že mluvím česky.
Zaujaly mě deepfaky. Chápu dobře, že dnes systémy ještě dokáží deepfake rozpoznat, ale v budoucnu už to nepůjde?
Je to trochu jako s počítačovými viry. Objevují se nové voice konvertory a syntetizátory, na které se musí systémy pro detekci deepfaků ve výzkumu i na trhu periodicky trénovat. Dnes vám tyto konvertory a syntetizátory řeči ještě v nahrávce ponechají různé artefakty či neobvyklé prvky, které se dají detekovat. Jenomže systémy se neustále zlepšují a dají se trénovat na čím dál menším množství dat. Dříve jste ke kvalitnímu hlasu potřeboval deset hodin ručně anotovaných dat, dnes to zvládnete během jednotek minut bez anotace. Pokud se tedy zmocníte něčího audiomateriálu z YouTube, Instagramu nebo odkudkoliv jinud, můžete si vyrobit jeho hlas.
Rusku bychom systémy nedodali
Zmiňujete dovednosti, kterými dnes systémy disponují. V jakých sektorech se dají využít?
Rozhodně v obraně a bezpečnosti, tedy sektorech, které v 70. letech stály u úplného počátku rozpoznávání řeči. Známé programy DARPA, které stály za internetem i dalšími technologiemi, byly vojenské. Na VUT jsme sami měli několik projektů od DARPA pro oblast vojenství a zpravodajství. Dnes se tyto systémy uplatňují i v komerci. Hlasoví asistenti na infolinkách call center představují obrovský trh a využití.
Dále se systémy dají využít v menších oblastech, například při pomoci psychoterapeutům při sezeních. V jednom projektu jsme takto analyzovali konverzaci mezi psychoterapeutem a klientem, abychom jim dali indikátory, zda sezení probíhá dobře. Bylo to úsměvné, protože na první schůzce na nás přišli s pojmy jako souznění či empatie, zatímco my jsme mluvili o korelačních koeficientech a chybovosti na úrovni slov. Jakmile jsme ale sladili slovník a očekávání, vzniklo z toho něco zajímavého.
A co nás teď hodně zajímá, je práce s piloty. Ve spolupráci s partnery z Vysokého učení technického v Brně (VUT) i odjinud se snažíme nasbírat data a vytvořit postupy, jak z řeči i z řady dalších senzorů rozpoznat, zda je pilot vystresovaný nebo přetížený.
Když zmiňujete bezpečnost – jak moc vědec při vývoji technologie myslí na to, že má v rukou mocný nástroj, který může být zneužit k politické kontrole, zásahům do lidského soukromí apod.?
Rozhodně na to myslíme a když něco vytvoříme, snažíme se o tom bavit s těmi dobrými, a ne se zlými hochy. Nebudu zakrývat, že spolupracujeme s českou policií i se zpravodajskými složkami pod různými ministerstvy. Měli jsme i evropský projekt, kde se toto řešilo na evropské úrovni. Rozhodně bychom takové systémy nedodali čínské tajné službě, do Ruska nebo Islámskému státu. Na druhou stranu nelze ohlídat úplně všechno, protože spoustu našeho výzkumu dáváme volně k dispozici na GitHub a Hugging Face a publikujeme články. Pokud by tedy ti zlí hoši měli specialisty, kteří by naši práci chtěli reprodukovat, někteří to jistě zvládnou.
Jak opravit špatnou nahrávku
Specializujete se na audio zvuk, který je nějakým způsobem nedokonalý. Jak se dá pracovat s nahrávkou, kde je řeč rozostřená nebo kde je hodně hluku v pozadí?
Když je nahrávka hodně špatná, tak vůbec. Občas se na nás obrátí soud nebo právníci a pošlou nám řečový signál s tím, že jsme odborníci a určitě to dokážeme vyčistit. Pokud ale nahrávka nenese ani kousek řeči, zázraky dělat nelze. Pokud je tam řeči alespoň trochu, dá se jít dvěma různými směry. Buď se nahrávku snažíme vyčistit tak, aby byla poslouchatelná pro lidi – k tomu máme algoritmy pro extrakci cílového mluvčího. Kdybyste měl ošklivou nahrávku z plné hospody se zapnutou televizí a hlukem v pozadí a my měli váš čistý hlasový otisk, dá se vytvořit algoritmus, který z té škaredé směsi vytáhne přímo váš hlas.
Nebo na to jdeme jinak: zvuk nečistíme, ale trénujeme rozpoznávací a detekční algoritmy, aby si s takovými daty dokázaly poradit a vytáhly obsah. Funguje to tak, že vezmeme čistou databázi, znečistíme ji různými šumy, zvuky z pozadí či dalšími mluvčími a nutíme naše modely pomocí standardních metod strojového učení, aby se v tom dokázaly zorientovat. Odborně se tomu říká augmentace dat, my tomu rádi říkáme „prasení dat“.
Která z těchto dvou variant má větší budoucnost?
To nemohu jednoznačně říct, záleží na cílovém použití. Pokud máte policistu, který si nahrávku chce poslechnout, musíte ji vyčistit. Když jde o přepis schůzky, který už nikdo poslouchat nebude, ale chcete mít zápis či sumarizaci toho, kdo a kdy co řekl, tam je lepší druhý způsob. Je potřeba pracovat na obou možnostech.
Co když mluví více řečníků najednou? Jak systémy při transkripci naučíte, který z řečníků je „důležitější“?
Zatím žádný systém neumí říct, který mluvčí je důležitější. Rozhodně se ale dají vytvořit systémy, které řečníky rozpoznají. Nebo se dá použít systém, se kterým jsme teď měli spoustu úspěchů: takzvaná diarizace. Jde o systém, který nezná identitu jednotlivých mluvčích a nikdy je neslyšel, ale dokáže nahrávku označkovat – určí, kde mluví mluvčí jedna, mluvčí dva a kde mluví přes sebe. Touto informací nakrmíme rozpoznávací model, který se následně zaměří na jednotlivé mluvčí, přepíše je separátně a přiřadí k nim text. Je pak na vás, případně na LLM či sumarizačním modelu, aby si v tom udělal pořádek a z kontextu zjistil, zda byl dotyčný hlavní řečník, nebo naopak někdo, kdo se na pozadí bavil o nepodstatných věcech.
Zametač cesty
Vaše práce na poli řečových systémů vám letos vynesla Národní cenu Česká hlava, nejvyšší české vědecké ocenění. Jak významné je pro vás a pro váš obor?
Česká hlava mi samozřejmě udělala obrovskou radost. Neberu ji totiž jako ocenění pro sebe – s oblibou říkám, že jsem spíše zametač cesty. Je to ocenění pro všechny šikovné lidi kolem mě. Chápu, že cenu museli dát jednomu člověku, tak ji dali tomu nejviditelnějšímu. Zároveň mě těší, že ocenění vyjadřuje uznání celému českému vědnímu ekosystému v oblasti umělé inteligence. V Česku máme spoustu lidí, kteří dosahují skvělých výsledků ve strojovém učení, robotice a zpracování přirozeného jazyka. Všechno je to dnes pod deštníkem AI a je dobře, že cena zamířila sem, protože česká vědecká elita je v něm velmi silná.
Když zmiňujete umělou inteligenci, hodí se uvést, že k analýze řeči jste se dostal přes výzkum neuronových sítí, tedy technologie, která je základem umělé inteligence.
To bylo docela zajímavé. K neuronovým sítím jsem se dostal během postdoku v americkém Oregonu u Hynka Heřmanského, světové celebrity ve zpracování řeči, který se tehdy věnoval jejímu rozpoznávání pomocí neuronových sítí. V té době tomu ale nikdo moc nevěřil. V letech 2000 až 2002 jsme se o něco snažili a lidé za námi chodili se slovy: „Ty jsi taky od Hynka a děláš na neuronových sítích, které nemají žádnou budoucnost?“
Až mezi lety 2005 a 2010 to začalo fungovat a lidé začali trochu věřit. Největší zlom nastal, když se technologie chopily velké firmy jako Google, Microsoft či IBM. V roce 2012 Geoffrey Hinton, Dong Yu a lidé z Microsoftu sepsali článek o tom, že rozpoznávání řeči pomocí neuronových sítí funguje, a všichni to najednou začali dělat. My jsme na tom pracovali už dávno předtím, ale jako malá laboratoř jsme neměli „PR“ velkých společností.
Tušil jste tehdy jako postdoktorand v Oregonu, jaký boom technologie jednou způsobí?
Občas se mě na to někdo ptá, tak odpovídám náboženským přirovnáním: když je člověk katolík, musí věřit, ale zároveň musí pochybovat. Věřil jsem a pochyboval současně. Když za vámi chodí známé osobnosti a říkají, že Hynkovy výmysly nikdy fungovat nebudou, zviklá vás to. Pak ale přijde Hynek a řekne, že to fungovat bude. Bylo to opravdu zajímavé období.
Hoši, pojďte dělat byznys
V roce 2006 jste spoluzaložil společnost Phonexia, která tehdy vznikající technologie na VUT přenesla do praxe. Jaké bylo zakládat spin-off před 20 lety?
V té době pro to na VUT ani jiných vysokých školách nepanovalo zrovna přátelské prostředí. Vládla obava, že když si někdo založí firmu, chce tunelovat školu a krást. Phonexia sice byla označována jako spin-off VUT, ale v praxi šlo o běžné s.r.o. Aby bylo vše právně v pořádku, Phonexia získala licenci na klíčovou technologii z VUT a proběhla standardní licenční smlouva a platby. VUT ale ve firmě nemělo majetkový podíl, byť jsme ji vždy brali jako úzce propojenou.
Proč jste se vrhl do podnikání?
Jednak jsem v zahraničí viděl, že spojení akademického a soukromého sektoru může být intenzivní, ve Francii jsem psal pro soukromou firmu část mé diplomky.
V Americe Hynek Heřmanský také vždy komunikoval s firemním sektorem a sám měl firemní zázemí. Přímý impuls k založení Phonexie byl ale jiný – inspirovala nás jednání s Ministerstvem obrany, které chtělo řečové technologie, ale s VUT jednat odmítlo. Univerzita pro ně byla moc velká a nechtěli, aby jejich smlouvy kolovaly po úřadech. Řekli nám: „Hoši, pokud s námi chcete spolupracovat, založte si firmu.“
Ještě firmu vlastníte?
Ne. Já a někteří kolegové jsme z firmy kolem roku 2010 vystoupili – chtěl jsem se věnovat práci na univerzitě a měl jsem také obavu ze střetu zájmů. Kdybych podepisoval smlouvy na obou stranách, mohli by mě za to zavřít, což bych opravdu nechtěl (smích). Někteří kolegové tam zůstali až do loňského roku, kdy se firma prodala korejské investiční skupině a došlo k úspěšnému exitu. Phonexia stále sídlí kousek od Fakulty informačních technologií VUT, jen má korejské vlastníky.
Jak moc se od té doby prostředí univerzitních spin-offů proměnilo?
Podstatně. Na mnohých vysokých školách, třeba u nás na VUT nebo na Českém vysokém učení technickém v Praze (ČVUT), se na budování spin-offů klade důraz. Na zmíněném ČVUT je rektorem Michal Pěchouček, který si na propojování akademického prostředí a praxe zakládá. Situace se tedy hodně zlepšila a dnes jsme rozhodně úplně jinde než před 20 lety.
AI zatím pomáhá
Je dnes rozvoj řečových systémů díky rozmachu AI podobně dynamický?
Je, možná až moc. Vidíte, co se děje na poli textových LLM modelů – AI v posledních letech začala „požírat“ i další modality: řeč, audio, obrázky či video. V Googlu to vedlo až k tomu, že zrušili výzkumné skupiny pro jednotlivé dílčí obory a vše vrhli na Gemini. V našem výzkumu jsme dříve vždy byli schopni kontrolovat celou výzkumnou pipeline: znali jsme modely a data, sami si udělali matematiku a natrénovali to na počítačích na fakultě ve sklepě. Před pěti lety ale velké firmy začaly produkovat předtrénované modely, které při svém tréninku viděly stovky tisíc hodin řečových dat. To je něco, co nemáme a ani bychom to na našich výpočetních prostředcích nedokázali natrénovat. Tyto modely navíc daly firmy volně k dispozici.
Co to v praxi znamená?
Znamená to, že velká část výzkumu se teď točí kolem toho, jak z předtrénovaných modelů ještě něco vymačkat a jak je upravit, aby dělaly i něco jiného, než na co byly původně určeny. S tím, co se děje v posledních letech, se nám rybníček zužuje a vysouší. Padají do něj obří modely a my musíme docela tvrdě přemýšlet o tom, co je ještě smysluplná práce. Dělat třeba přepis čisté řeči v angličtině nemá cenu – ten vám běží v mobilu, v autě nebo si stáhnete model z platformy Hugging Face a problém je vyřešen.
To byla má další otázka, jestli situace nepovede tak daleko, že AI ve vašem oboru nahradí práci vědců.
Zatím nám AI hlavně pomáhá. Pořád se nám daří nacházet místa, kde se dá dělat zajímavý výzkum. Předtrénované modely, jako je Whisper od OpenAI, umí kvalitně přepisovat řeč jednoho mluvčího, a to i v různých jazycích. Nejsou ale dobré na konverzaci více mluvčích – například na schůzkách, kde si lidé skáčou do řeči a překřikují se. Můžeme tak zatím pracovat na systémech, které rozpoznají mluvčí, a upravit Whisper tak, aby jako další vstup bral pravděpodobnosti mluvčích. Whisper je ale tak dobrý, že si nemůžeme hrát na to, že bychom místo něj vytvořili něco vlastního. Model nicméně můžeme vzít a snažit se jej přizpůsobit pro novou zajímavou úlohu, kterou předtím neuměl.
Je toto nicméně těžší a těžší? Vymýšlet, co dalšího ještě řečové systémy učit?
Řekl bych, že ne. Téma obvykle vyplyne samo – buď vidíme výzkumnou potřebu, nebo přijde firma či partnerská laboratoř s konkrétním problémem. Příkladem může být zmiňovaný stres a zátěž pilotů. Práce na toto téma sice existují, málo z nich ale využívá pokročilé předtrénované modely. Zásadním problémem jsou navíc data – chybí dostatek reprezentativních dlouhých nahrávek pilotů, kteří letí v klidu, pak je něco vystresuje a následně se opět uklidní.
Tomu se teď tedy věnujete?
Ano, na shromažďování takových dat teď tvrdě pracujeme. Stresujeme piloty – zatím na simulátoru, časem i v reálném letadle. Doufám ale, že nikdo nespadne (smích). Zároveň nabíráme spoustu senzorických dat z řeči, kamer či snímačů okysličení mozku a pracujeme na části strojového učení, abychom poznali, zda a jak moc je člověk vystresovaný.
Foto: FILMONDO, archiv Jana Černockého
Jan Černocký je přední český počítačový vědec a odborník na zpracování řeči. Působí jako vedoucí Ústavu počítačové grafiky a multimédií (UPGM) na Fakultě informačních technologií Vysokého učení technického v Brně (FIT VUT). V roce 1997 založil výzkumnou skupinu BUT Speech@FIT, kterou dodnes vede. Spoluzaložil společnost Phonexia, která technologie vyvinuté na VUT přenesla do praxe a v současnosti je dodává do více než 60 zemí. Vede mezinárodní projekty, organizuje prestižní světové konference a rozvíjí zázemí pro talentované vědce. V roce 2026 za svou dlouhodobou práci obdržel Národní cenu vlády Česká hlava, nejvyšší české vědecké ocenění.
- Autor článku: ano
- Zdroj: VědaVýzkum.cz


